Ataraxos 和人类 Stratego 冠军打了 20 局,结果是 15 胜、1 负、4 平。这个数字本身已经够刺眼,但更刺眼的是另一件事:它不是靠一座算力山砸出来的,而是用相对克制的学术预算,把一个长期卡住 AI 的游戏缺口撕开了。
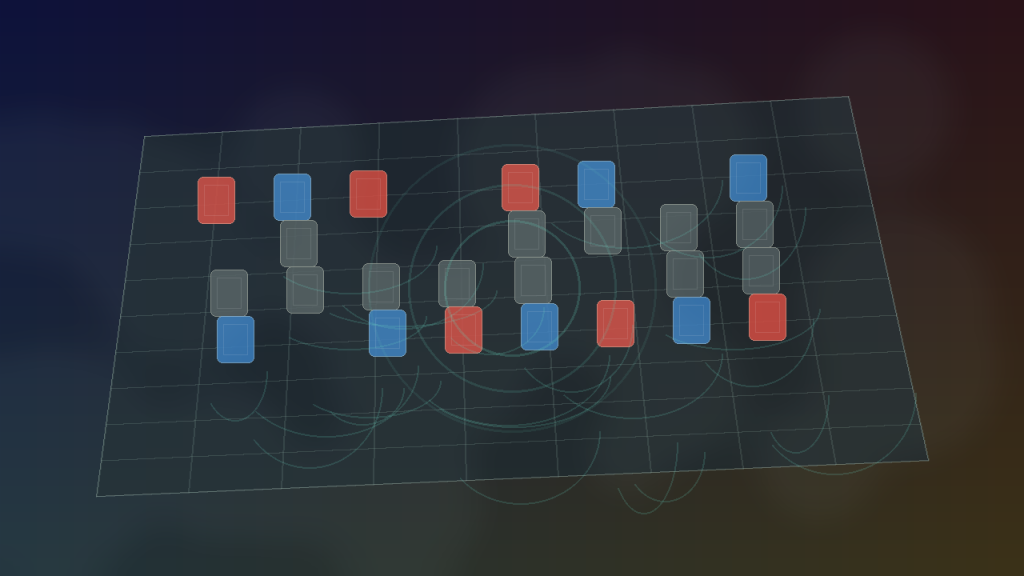
Stratego 可以粗略理解成一种带战争迷雾的棋。双方先把 40 个棋子背面朝上摆好,彼此只知道位置,不知道身份。只有碰撞时,棋子的军衔才会暴露。棋类 AI 最喜欢的清楚局面,在这里一开始就不存在。
这也是它难的地方。国际象棋和围棋里,棋盘信息都摊在桌面上;德州扑克有隐藏信息,但初始牌型数量还在可计算范围内。Stratego 的可能布阵超过 10 的 33 次方,一局还可能拖到上千步。AI 不是简单找最优招,而是要一边行动,一边猜对手手里到底藏着什么。
真正的新东西不是赢了游戏
Nature 论文把 Ataraxos 的核心拆成三块:自我对弈训练、预测隐藏棋子的 belief network,以及落子前的即时搜索。说得白一点,它先学一套大体策略,再在每一步之前生成一些“对手可能是什么棋”的版本,拿这些版本试算,再决定怎么走。
这听起来像人类玩家的直觉:看对手怎么走,推测他在遮什么。但机器的优势在于,它可以把这种猜测变成大量可重复的模拟,而且不会因为自己知道某个秘密就露出破绽。Ars Technica 的报道里,研究者提到一个很有意思的点:人知道秘密时,很难假装自己不知道;机器反而可以把这种“不露相”执行得更冷。
我觉得这里比“AI 又赢了一个棋类游戏”更重要。它解决的不是下棋,而是在信息不完整时怎样保持稳定判断。公司谈判、金融市场、网络攻防、军事推演,很多现实决策都不是全图可见的棋盘。Stratego 只是一个规则足够清楚、胜负足够明确的试验场。
便宜,反而让这件事更麻烦
The Decoder 根据论文梳理的数据是,DeepMind 早年的 DeepNash 需要长时间使用大量 TPU,Ataraxos 的训练成本则被研究团队估算为不到 8000 美元。这个对比不能简单理解成“学术界打败大厂”,因为工程实现、评测条件和年份都不完全一样。但它至少说明一件事:某些能力进步,不一定只靠更大的模型和更多芯片。
这对行业判断很关键。过去两年,很多人默认 AI 能力的边界主要由算力决定。Ataraxos 给出的信号更窄,也更锋利:在一些具体问题上,算法结构、模拟器速度、训练稳定性,可能比盲目堆资源更值钱。
边界也要说清楚。Nature 论文没有证明 AI 已经能处理真实世界所有不完整信息问题。现实里的谈判和市场没有固定棋盘,目标函数也不会像胜负那么干净。Ataraxos 现在还不能很好解释自己为什么这么走。强,但不透明。这在游戏里可以接受,放进金融、军事或企业决策,就会变成治理问题。
AI 的下一张考卷是灰区
AlphaGo 时代,AI 给人的震动是“它在公开棋盘上算得比人远”。Ataraxos 这类工作更像另一种信号:AI 正在学会在看不全、猜不准、还要防对手试探的环境里做决定。
这不一定立刻变成某个面向普通用户的新产品。短期看,它更像一块方法论拼图,提醒我们别只盯着聊天窗口和模型榜单。真正难的系统,往往不是回答清楚问题,而是在缺信息、缺信任、缺解释时仍然不乱下注。
我的判断是:如果 AI 公司以后想把代理放进高风险业务,只会“会说话”远远不够。它必须在灰区里保持判断,还要让人知道它为什么这么判断。Ataraxos 把前半步走出来了,后半步才是更难的门槛。
消息来源
- Nature: https://www.nature.com/articles/s41586-026-11036-y
- Ars Technica: https://arstechnica.com/science/2026/10/ai-finally-beat-the-best-stratego-player-in-history-and-did-it-on-a-budget/
- The Decoder: https://the-decoder.com/ai-beats-strategos-greatest-player-ending-one-of-the-last-human-strongholds-in-board-games/